TrendForge V2 · 内容供给引擎
把内容供给的关键流程交给 AI:信号捕捉、趋势研判、受众洞察、角度设计、证据检索、写作、 选题守卫、事实核查、总编审核、形态适配、分发策略。人负责定义标准,AI 在真实消费反馈中持续进化。 控制台 9 个模块、14 个 Agent 协同,任务在服务端运行,切页面或刷新都不中断。
我是廖持权。做过 AI Native 内容供给引擎、跨文化内容适配 Agent, 也做过能自己盯着我写简历的 桌面监管助手。 我的做法是:把模糊目标拆成可验证的工程闭环,然后把它真的跑起来。
四个真实跑起来的项目。能在线打开的直接给链接,桌面端给截图——不写跑不起来的演示。
点击任意卡片可查看完整拆解。部分项目部署在免费实例上,首次打开需要唤醒。
把内容供给的关键流程交给 AI:信号捕捉、趋势研判、受众洞察、角度设计、证据检索、写作、 选题守卫、事实核查、总编审核、形态适配、分发策略。人负责定义标准,AI 在真实消费反馈中持续进化。 控制台 9 个模块、14 个 Agent 协同,任务在服务端运行,切页面或刷新都不中断。
三个 Agent 接力工作:文化语境分析师拆解原文的文化绑定元素 → 本地化主编结合文化知识库 改写成目标语言 → 文化风险审核官按五维标准做发布前审核。解决内容出海时「翻译对了但语境错了」的问题。
一只由 Three.js 实时驱动的钟表机械蝴蝶。可拖拽环绕、滚轮推拉,触发「能量过载」会看到机芯 从满载到过载的完整反馈。单文件、零外部依赖,用最直接的方式说明我做交互的手感。
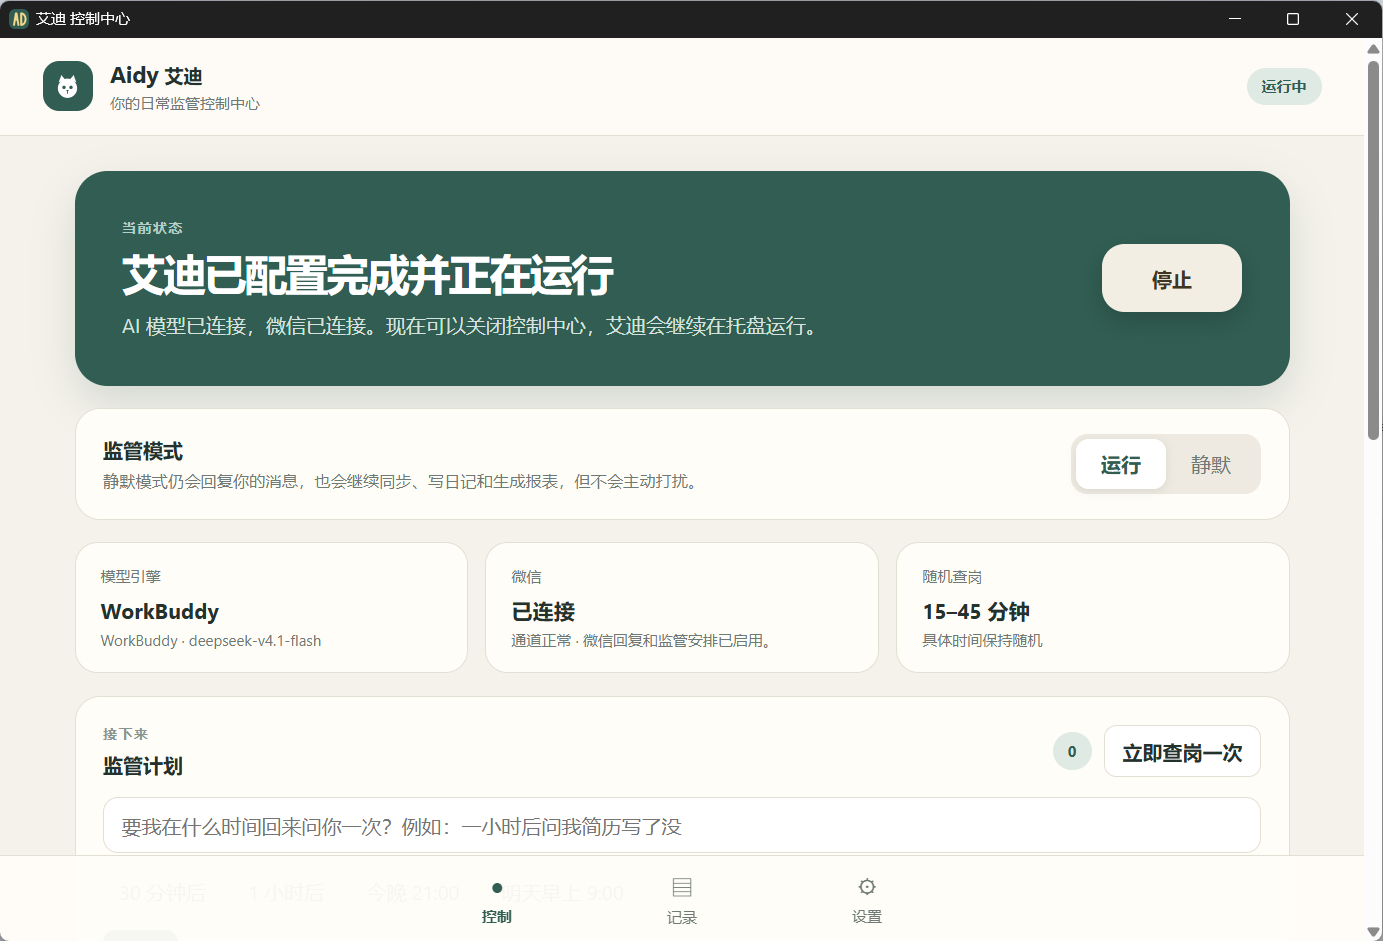
打开项目 →Windows 桌面端。AI 模型与微信双通道连接,按 15–45 分钟随机查岗——回来问你一句 「简历写了没」。支持运行/静默两种监管模式,自动同步、写日记、生成报表, 关闭控制面板后继续在托盘运行。本质是给拖延症做的一个外部监督机制。
桌面应用 · 暂无网页版,以截图展示
四个环节我都真正做过一遍——不是只会画原型。
生物学的训练核心其实是在噪声里找信号——设计对照、排除干扰、判断一个差异到底是真的还是随机波动。 这件事和判断一条热点值不值得跟进、一个 AI 输出到底靠不靠谱,底层是同一套思维。
真正的转折是我自己在用 AI 工具的过程中不断发现「这里明明可以更好」。从提需求到自己动手做出来, 中间没有断点——这就是我现在做的事。学历背景不是包袱,它给了我不轻易被结论说服的习惯。
因为全自动的问题不是「做不到」,而是「错了没人负责」。内容一旦发出去就收不回来, 事实核查错了、口径偏了,代价是真实的。
所以我在管线里设了选题守卫和人工审核闸门:AI 提议、人拍板。同时做了五维校准模块, 让机器评委分与真人打分做 Spearman 对齐——差值本身就是这个模块存在的理由。 系统进化也遵循同样逻辑:AI 提议改 Prompt,你采纳才生效,看完效果还能随时回滚。
我的第一个问题是:这个环节现在有人在为此痛,还是只是看起来该自动化? 很多 AI 功能失败不是因为模型不行,是因为它解决的是个不存在的问题。
第二个问题:错了能不能发现、能不能撤回。能发现、能撤回的,大胆上;不能的,必须留人在环里。 Aidy 就是个例子——它查岗的强度我特意做成 15–45 分钟随机,因为固定频率会让人产生预期, 有了预期就会开始应付。这种细节才是产品感。
这些项目没有一个是「作业」。它们都是我自己遇到问题、自己决定要做、自己推到底的。 TrendForge 的 PromptManager 热升级、Aidy 的随机调度、蝴蝶页的单文件优化,都是在真实约束下做的取舍。
我想去大厂恰恰是因为这里的约束是真实的:真实用户、真实指标、真实线上事故。 独立做项目教会我的是从 0 到 1 的完整链路,我现在想学的是从 1 到 100 的系统性。
是。主页、机械蝴蝶、以及上面所有项目, 从拆需求到上线部署都是我自己完成的。
顺带说一句:这个站本身也算一个作品——零依赖、纯静态、境外托管, 没有框架负担,打开就能用。我比较信「能跑起来才算做完」。